Кто пишет в Интернете: на трети веб-страниц это не люди
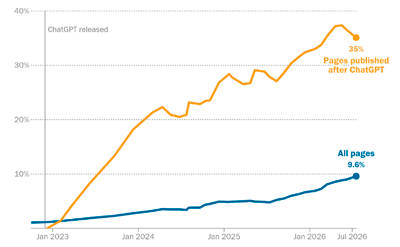
Исследователи из Pew Research, проанализировав 10 тыс. случайно выбранных англоязычных веб-страниц, сочли, что примерно 10% носят явные следы ИИ-генерации. Но если брать тексты, которые появились после открытия свободного доступа к ChatGPT в конце 2022 г., то доля таких текстов составляет все 35%.
Какую долю веб-страниц можно с уверенностью атрибутировать как порожденную не людьми, а искусственным интеллектом? Таким вопросом задались исследователи из Pew Research, имея в виду, конечно, размещенный на этих страницах текст; авторство ИИ в создании HTML-кода установить куда сложнее. Первичный анализ показал, что из 10 тыс. случайным образом выбранных англоязычных веб-страниц примерно 10% носят явные следы ИИ-генерации, т. е. этот текст либо был просто скопирован из окна диалога с ChatGPT или иным ботом и сразу же размещен в сети, либо подвергался лишь минимальной человеческой корректуре – с сохранением большинства присущих такой генерации особенностей.
Однако затем исследователи сделали следующий логичный шаг: поскольку нынешний ИИ-бум разразился после того, как в конце 2022 г. OpenAI открыла свободный доступ к своему умному боту ChatGPT, разумно было бы оценить долю созданных ИИ онлайновых текстов не от всех доступных в Интернете страниц, а только от тех, которые появились в конце 2022 г. и позже. Так вот, для этой зауженной выборки результат оказался куда более впечатляющим – 35% (см. рисунок).
В Pew Research оговариваются, что приведенные значения следует воспринимать лишь как приблизительные оценки: не существует некоей объективной метки, которая однозначно бы позволяла идентифицировать текст как сгенерированный ИИ, а не написанный человеком. Однако косвенные признаки имеются, и само увеличение частоты фиксации этих самых признаков в онлайновых текстах после начала ИИ-ажиотажа служит подтверждением корректности избранных критериев.
К примеру, один из наиболее ярких признаков сгенерированного машиной англоязычного текста – длинное типографское тире (—). Оно чаще всего используется в художественных и академических произведениях (которые составляют львиную долю обучающего массива для любого ИИ), и потому умные боты его активно применяют. Люди же, пишущие вручную, там, где требуется тире, обыкновенно ставят просто дефис (-), который текстовые редакторы – прежде всего, разумеется, Microsoft Word – по умолчанию преобразуют в короткое тире (−); так уж исторически сложилось.
Понятно, само по себе наличие длинных тире в тексте не позволяет априори отнести его к ИИ-сгенерированным, но, по подсчетам Pew Research, с начала 2023 г. по середину 2026-го частота появления символа «—» в онлайновых текстах выросла вдвое. Аналогичная ситуация с «оксфордской запятой» (oxford comma): это запятая, которая по правилам американского английского ставится при перечислениях перед союзами «and» или «or»; т. е. «we need bread, butter, and salt». В то же время в британском английском эта запятая, даром что «оксфордская», ставится лишь в исключительных случаях, а рядовые англоязычные пользователи в повседневной переписке ее практически игнорируют. Так вот, этот знак препинания за время ИИ-ажиотажа стал встречаться на веб-страницах чаще на 63%.
Аналогичная история – со всеми прочими косвенными признаками ИИ-генерации, которые в Pew Research использовали для оценок. Эксперты констатируют также, что все больше онлайновых сервисов (новостных сайтов, коммуникационных платформ, таких как Reddit, даже специализированных порталов) делают ставку на смартфонные приложения, а не на классические веб-страницы, чтобы взаимодействовать со своими читателями накоротке и как можно плотнее. А это оставляет еще больше простора для обезлюживания старого доброго Интернета и заполнения его текстами за авторством больших языковых моделей.